Deep Learning é um dos assuntos mais badalados e cobrados em concursos de TI, dados e engenharia de software. Dominar seus fundamentos — principalmente o processo de ajuste de pesos — é condição sine qua non para gabaritar questões de bancas como a FGV, Cebraspe e FCC. Veja a questão base que originou esta aula (FGV, 2024 — MACAEPREV, Conhecimentos Específicos, Q. 68):
“Deep learning (aprendizado profundo) é uma subárea do aprendizado de máquina que se concentra em algoritmos baseados em redes neurais artificiais profundas. Essas redes neurais têm várias camadas intermediárias entre a entrada e a saída, permitindo que o sistema aprenda representações de dados em múltiplos níveis de abstração. Em deep learning, o seguinte conceito se refere ao processo de ajustar os pesos de uma rede neural durante o treinamento, de modo a minimizar a função de perda:
A) Inicialização de Pesos B) Normalização C) Propagação para Frente (Forward Propagation) D) Backpropagation E) Dropout
A alternativa correta é a D) Backpropagation. Mas por que exatamente? E por que as demais estão erradas? Vamos destrinchar cada detalhe agora.
1. Fundamentos de Redes Neurais Artificiais
1.1 Estrutura Básica
Uma rede neural é composta por camadas de neurônios artificiais. Cada neurônio recebe entradas, multiplica-as por pesos, adiciona um bias e aplica uma função de ativação. As camadas se organizam em:
- Entrada: onde os dados brutos são alimentados.
- Ocultas: responsáveis por aprender representações cada vez mais abstratas.
- Saída: gera a predição da rede.
1.2 Função de Perda
É o critério que quantifica o erro da rede. Exemplos: Cross-Entropy para classificação, MSE para regressão. O objetivo do treinamento é minimizar essa função.
2. Backpropagation: Conceito e Mecanismo
2.1 Definição
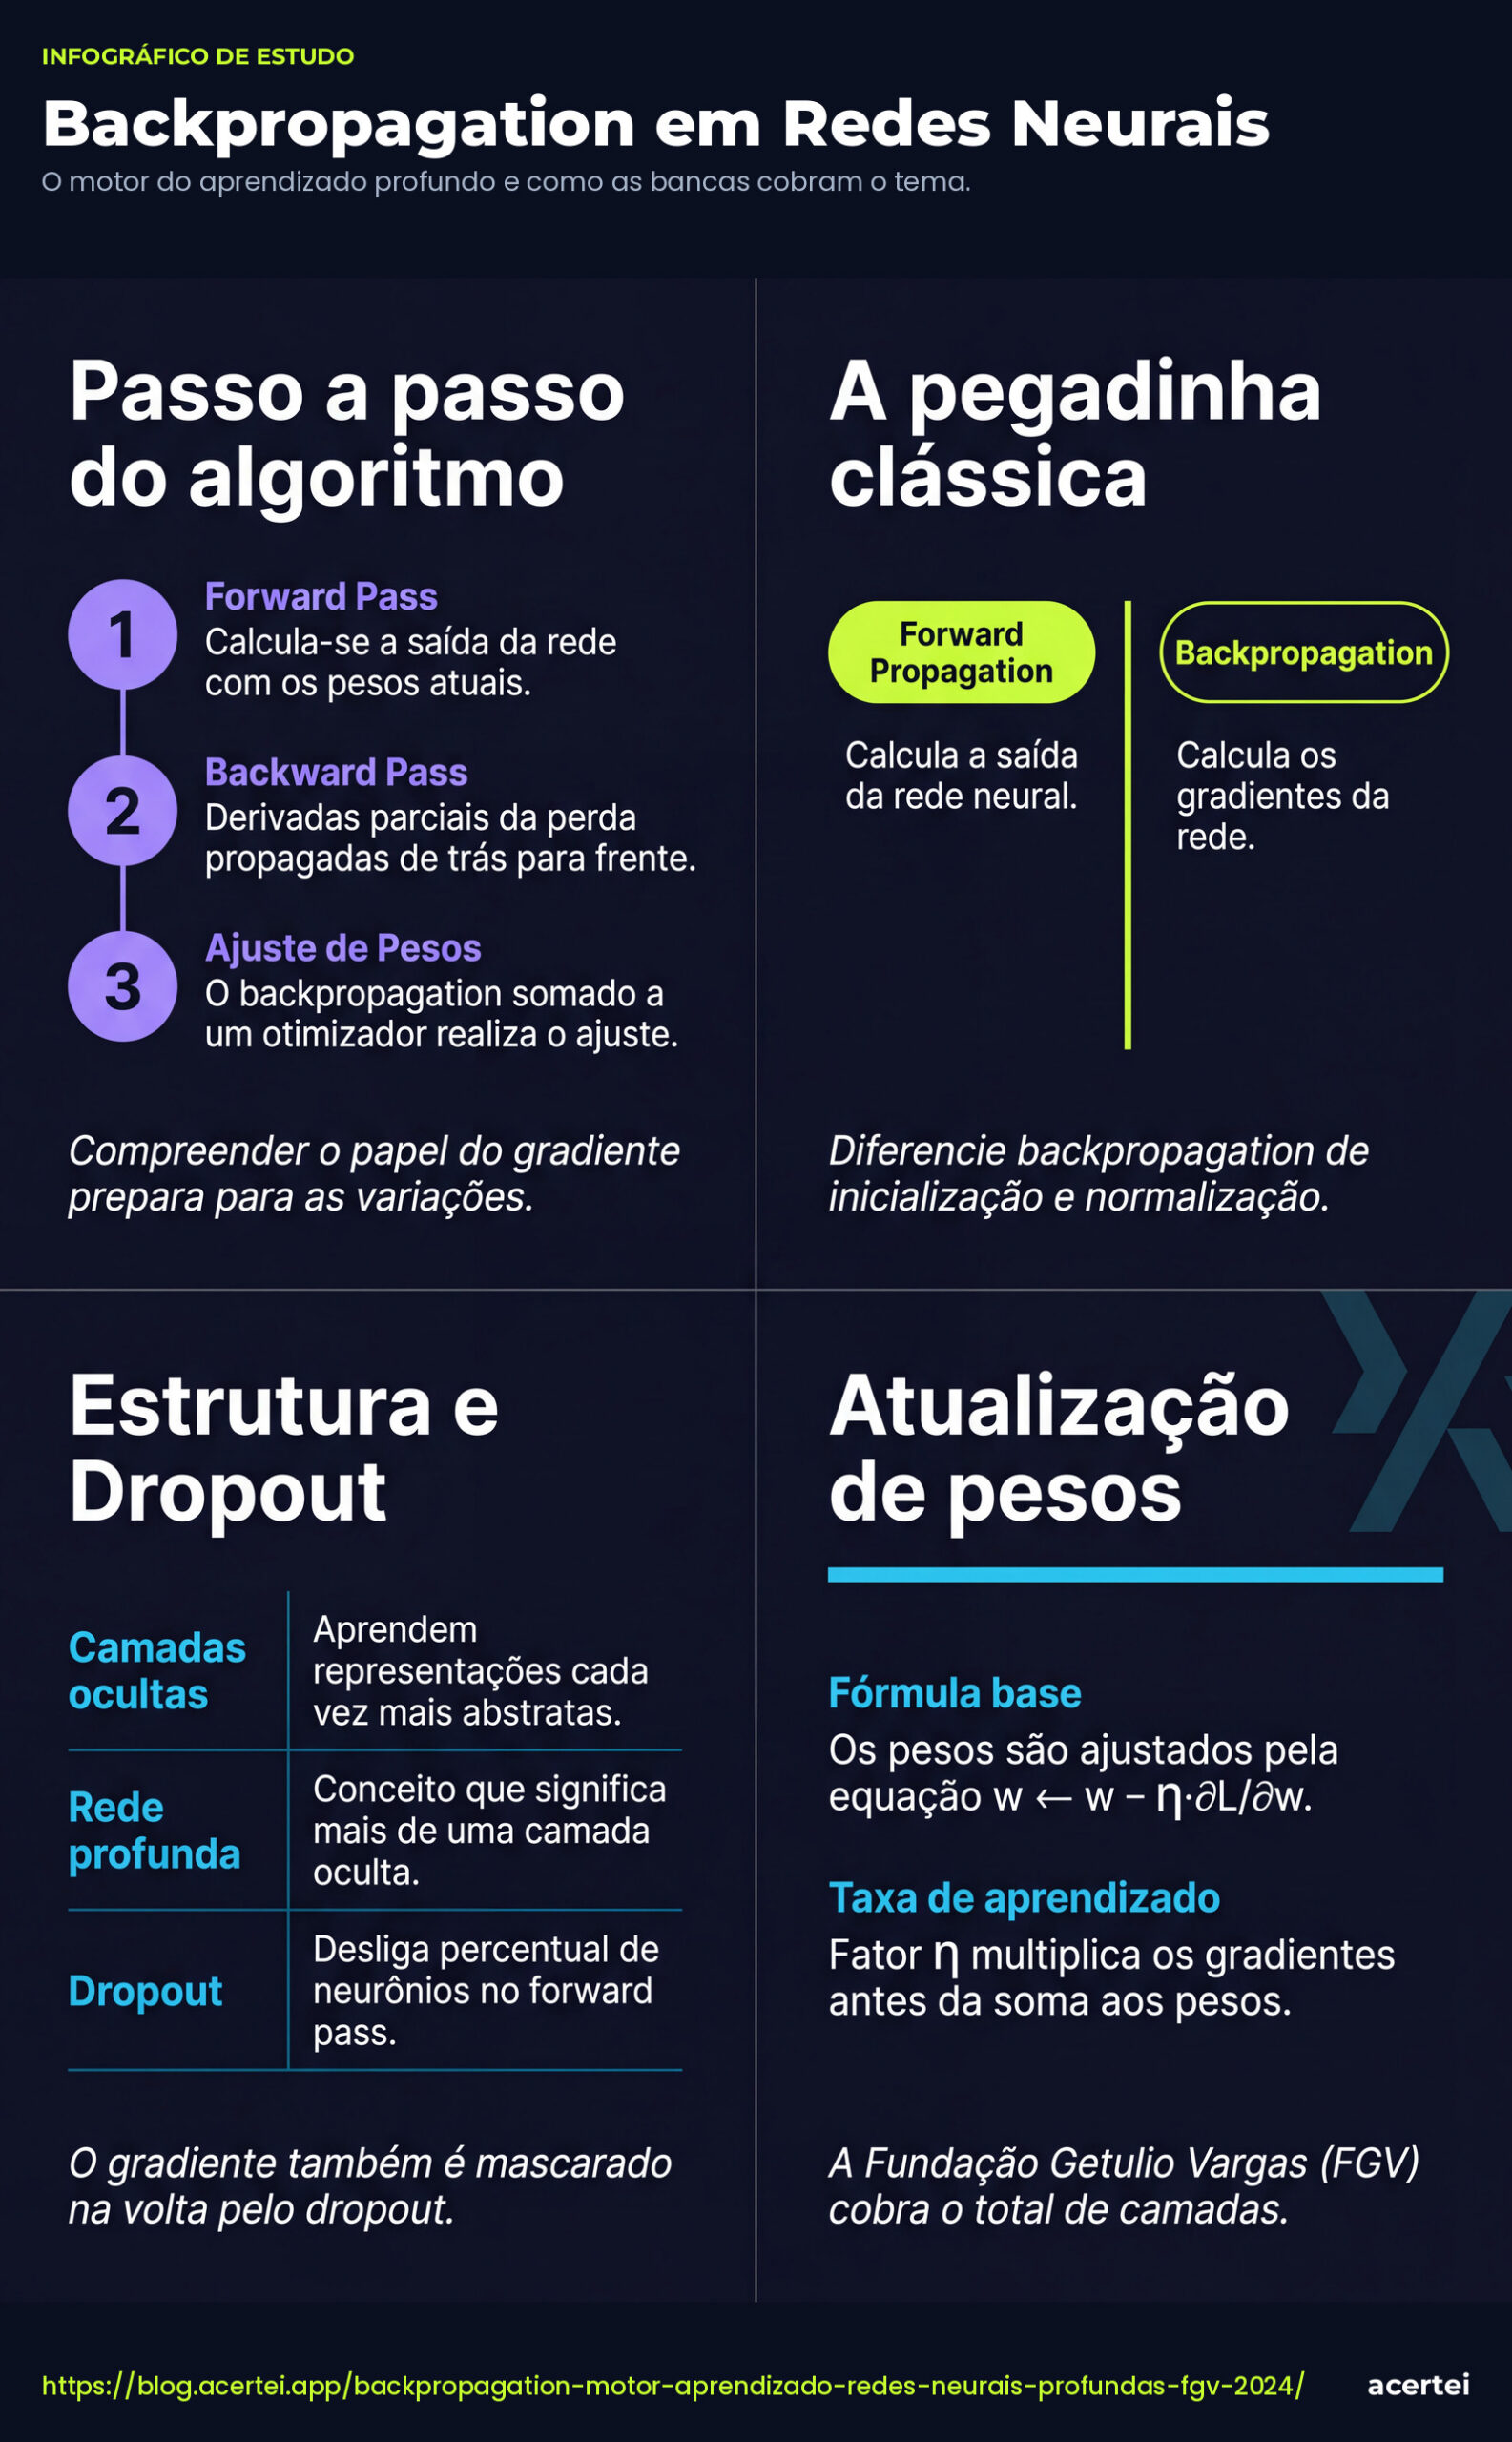
Backpropagation (retropropagação do erro) é o algoritmo que propaga o gradiente do erro da camada de saída para as camadas anteriores, calculando quanto cada peso contribuiu para o erro. A partir daí, utiliza-se um otimizador (ex.: Gradient Descent, Adam) para atualizar os pesos na direção de menor perda.
2.2 Passos do Algoritmo
- Forward Pass: calcula-se a saída da rede com os pesos atuais.
- Cálculo da Perda: compara saída com rótulo real.
- Backward Pass: derivadas parciais da perda w.r.t. (em relação a) cada peso são propagadas de trás para frente.
- Atualização de Pesos: pesos são ajustados w ← w − η·∂L/∂w, onde η é a taxa de aprendizado.
3. Por Que as Outras Alternativas Estão Erradas?
A) Inicialização de Pesos
Refere-se ao método de atribuir valores iniciais aos pesos antes do treinamento (e.g., He, Xavier). Não ajusta pesos ao longo do treinamento, logo não minimiza a perda.
B) Normalização
Pode ser normalização de dados (escala) ou Batch Normalization (normaliza ativações). Embora ajude a treinar, não é o processo que ajusta os pesos; é um pré-/pós-processamento.
C) Propagação para Frente (Forward Propagation)
Apenas realiza o cálculo da saída com os pesos atuais; não há retroalimentação de erro, portanto não há minimização da perda.
E) Dropout
Técnica de regularização que “desliga” aleatoriamente neurônios durante o treinamento para evitar overfitting. Novamente, não é responsável por atualizar pesos.
4. Otimização e Algoritmos Complementares
Backpropagation fornece o gradiente, mas quem efetivamente move os pesos é o otimizador. Exemplos: Stochastic Gradient Descent, Adam, RMSProp, Adagrad. Conceitos como taxa de aprendizado, momentum e decaimento de taxa aparecem em editais avançados.
Conclusão
Backpropagation é o pilar sobre o qual todo treinamento de redes neurais se sustenta. Saber diferenciar esse processo de técnicas auxiliares — inicialização, normalização, forward, dropout — é essencial para não cair em pegadinhas de prova. Revise o algoritmo passo a passo, compreenda o papel do gradiente e dos otimizadores, e você estará preparado para qualquer variação que a banca tente impor.
Mapa da Aprovação: Resumo Esquematizado
Deep Learning ├─ Redes Neurais Profundas │ ├─ Camada Entrada │ ├─ Camadas Ocultas │ └─ Camada Saída ├─ Função de Perda (L) ├─ Treinamento │ ├─ Forward Propagation → calcula ŷ │ ├─ Calcula L(ŷ, y) │ ├─ Backpropagation → ∂L/∂w │ └─ Otimizador → w ← w – η·∂L/∂w ├─ Técnicas de Apoio │ ├─ Inicialização (He, Xavier) │ ├─ Normalização (BatchNorm / Data Scaling) │ └─ Dropout (Regularização) └─ Pegadinhas de Prova ├─ Confundir Forward × Backward ├─ Achar que BatchNorm otimiza pesos └─ Esquecer papel do Otimizador
Teste Seus Conhecimentos: Questões de Fixação
Questão 1. Em uma rede neural profunda, qual das opções abaixo corresponde ao componente que RECEBE o gradiente calculado pelo backpropagation e efetua a atualização dos pesos?
- Função de Ativação
- Otimizador (por exemplo, Adam ou SGD)
- Layer de Dropout
- Inicialização Xavier
Gabarito: B
Comentário: O otimizador é quem atualiza os pesos — ele usa o gradiente fornecido pelo backpropagation. A) Função de ativação apenas aplica não linearidade. C) Dropout desliga neurônios e não move pesos. D) Xavier define os valores iniciais dos pesos.
Questão 2. Durante o treinamento, o algoritmo de backpropagation utiliza qual ferramenta matemática para determinar a contribuição de cada peso para o erro total?
- Algoritmo de Hashing
- Método dos Mínimos Quadrados
- Regressão Logística
- Cálculo de Gradientes (Derivadas Parciais)
Gabarito: D
Comentário: A essência do backpropagation é a derivação da função de perda em relação a cada peso (gradientes). A) Hashing não aparece no processo. B) Mínimos Quadrados é perda para regressão linear. C) Regressão Logística é um modelo, não cálculo de gradientes.
Questão 3. (Certo ou Errado) — O procedimento de Batch Normalization, ao normalizar as ativações de cada mini-batch, substitui completamente a necessidade do backpropagation, pois ajusta automaticamente os pesos da rede.
Gabarito: Errado
Comentário: Batch Normalization não ajusta pesos; ele normaliza valores intermediários para acelerar e estabilizar o treinamento. O ajuste de pesos continua sendo feito via backpropagation + otimizador.
Questão 4. Uma rede neural foi inicializada com a estratégia He e, após algumas épocas, apresentou overfitting. Qual técnica das abaixo ajuda especificamente a mitigar esse problema ao “desligar” neurônios durante o treinamento?
- Backpropagation
- Dropout
- Forward Propagation
- Gradient Clipping
Gabarito: B
Comentário: Dropout é a técnica de regularização descrita. A) Backpropagation ajusta pesos, não regulariza por si só. C) Forward é passagem de dados. D) Gradient Clipping evita explosão de gradientes, não necessariamente overfitting.
Questão 5. No contexto do algoritmo de backpropagation, o termo “taxa de aprendizado” (learning rate) representa:
- O número de épocas necessárias para a convergência.
- O fator pelo qual os gradientes são multiplicados antes de serem somados aos pesos.
- A fração da base de dados usada para validação.
- O percentual de neurônios desligados pelo dropout a cada iteração.
Gabarito: B
Comentário: A taxa de aprendizado (η) escala o gradiente na equação de atualização dos pesos. A) Número de épocas é hiperparâmetro distinto. C) Está ligado a train/validation split. D) Refere-se ao parâmetro de dropout, não learning rate.