A escolha do algoritmo de machine learning correto é um passo crucial em qualquer projeto de ciência de dados e um tema recorrente em concursos públicos na área de Tecnologia da Informação. A questão que inspira esta aula, proveniente do concurso para Auditor de Controle Externo do TCE SP (2023), nos apresenta um cenário prático: a necessidade de criar um modelo interpretável para prever o cancelamento de serviços, usando dados tabulares com atributos variados e regras de escolha complexas. A resposta correta, “árvore de decisão”, nos serve como ponto de partida para explorar não apenas por que ela é a melhor escolha, mas também para entender as características e limitações dos outros algoritmos mencionados.
O Cenário do Problema: Interpretability vs. Complexidade
O enunciado da questão-base nos dá três pistas fundamentais para a escolha do algoritmo:
- Modelo Interpretável: A necessidade de que as previsões do modelo possam ser compreendidas por humanos. Em um contexto de negócio, como o cancelamento de clientes (churn), é vital entender *por que* um cliente é classificado como propenso a cancelar.
- Problema Tabular: Os dados estão organizados em uma tabela (linhas e colunas), com diferentes tipos de atributos (demográficos, de serviço, etc.).
- Regras de Escolha Complexas: A relação entre os atributos e a decisão de cancelamento não é simples ou linear.
Árvore de Decisão: A Escolha Correta e Suas Vantagens
Uma árvore de decisão é um modelo que se assemelha a um fluxograma. Cada nó interno representa um “teste” em um atributo (ex: “O cliente tem mais de 2 anos de contrato?”), cada ramo representa o resultado do teste, e cada nó folha representa um rótulo de classe (cancelou ou não cancelou).
Por que ela se encaixa perfeitamente?
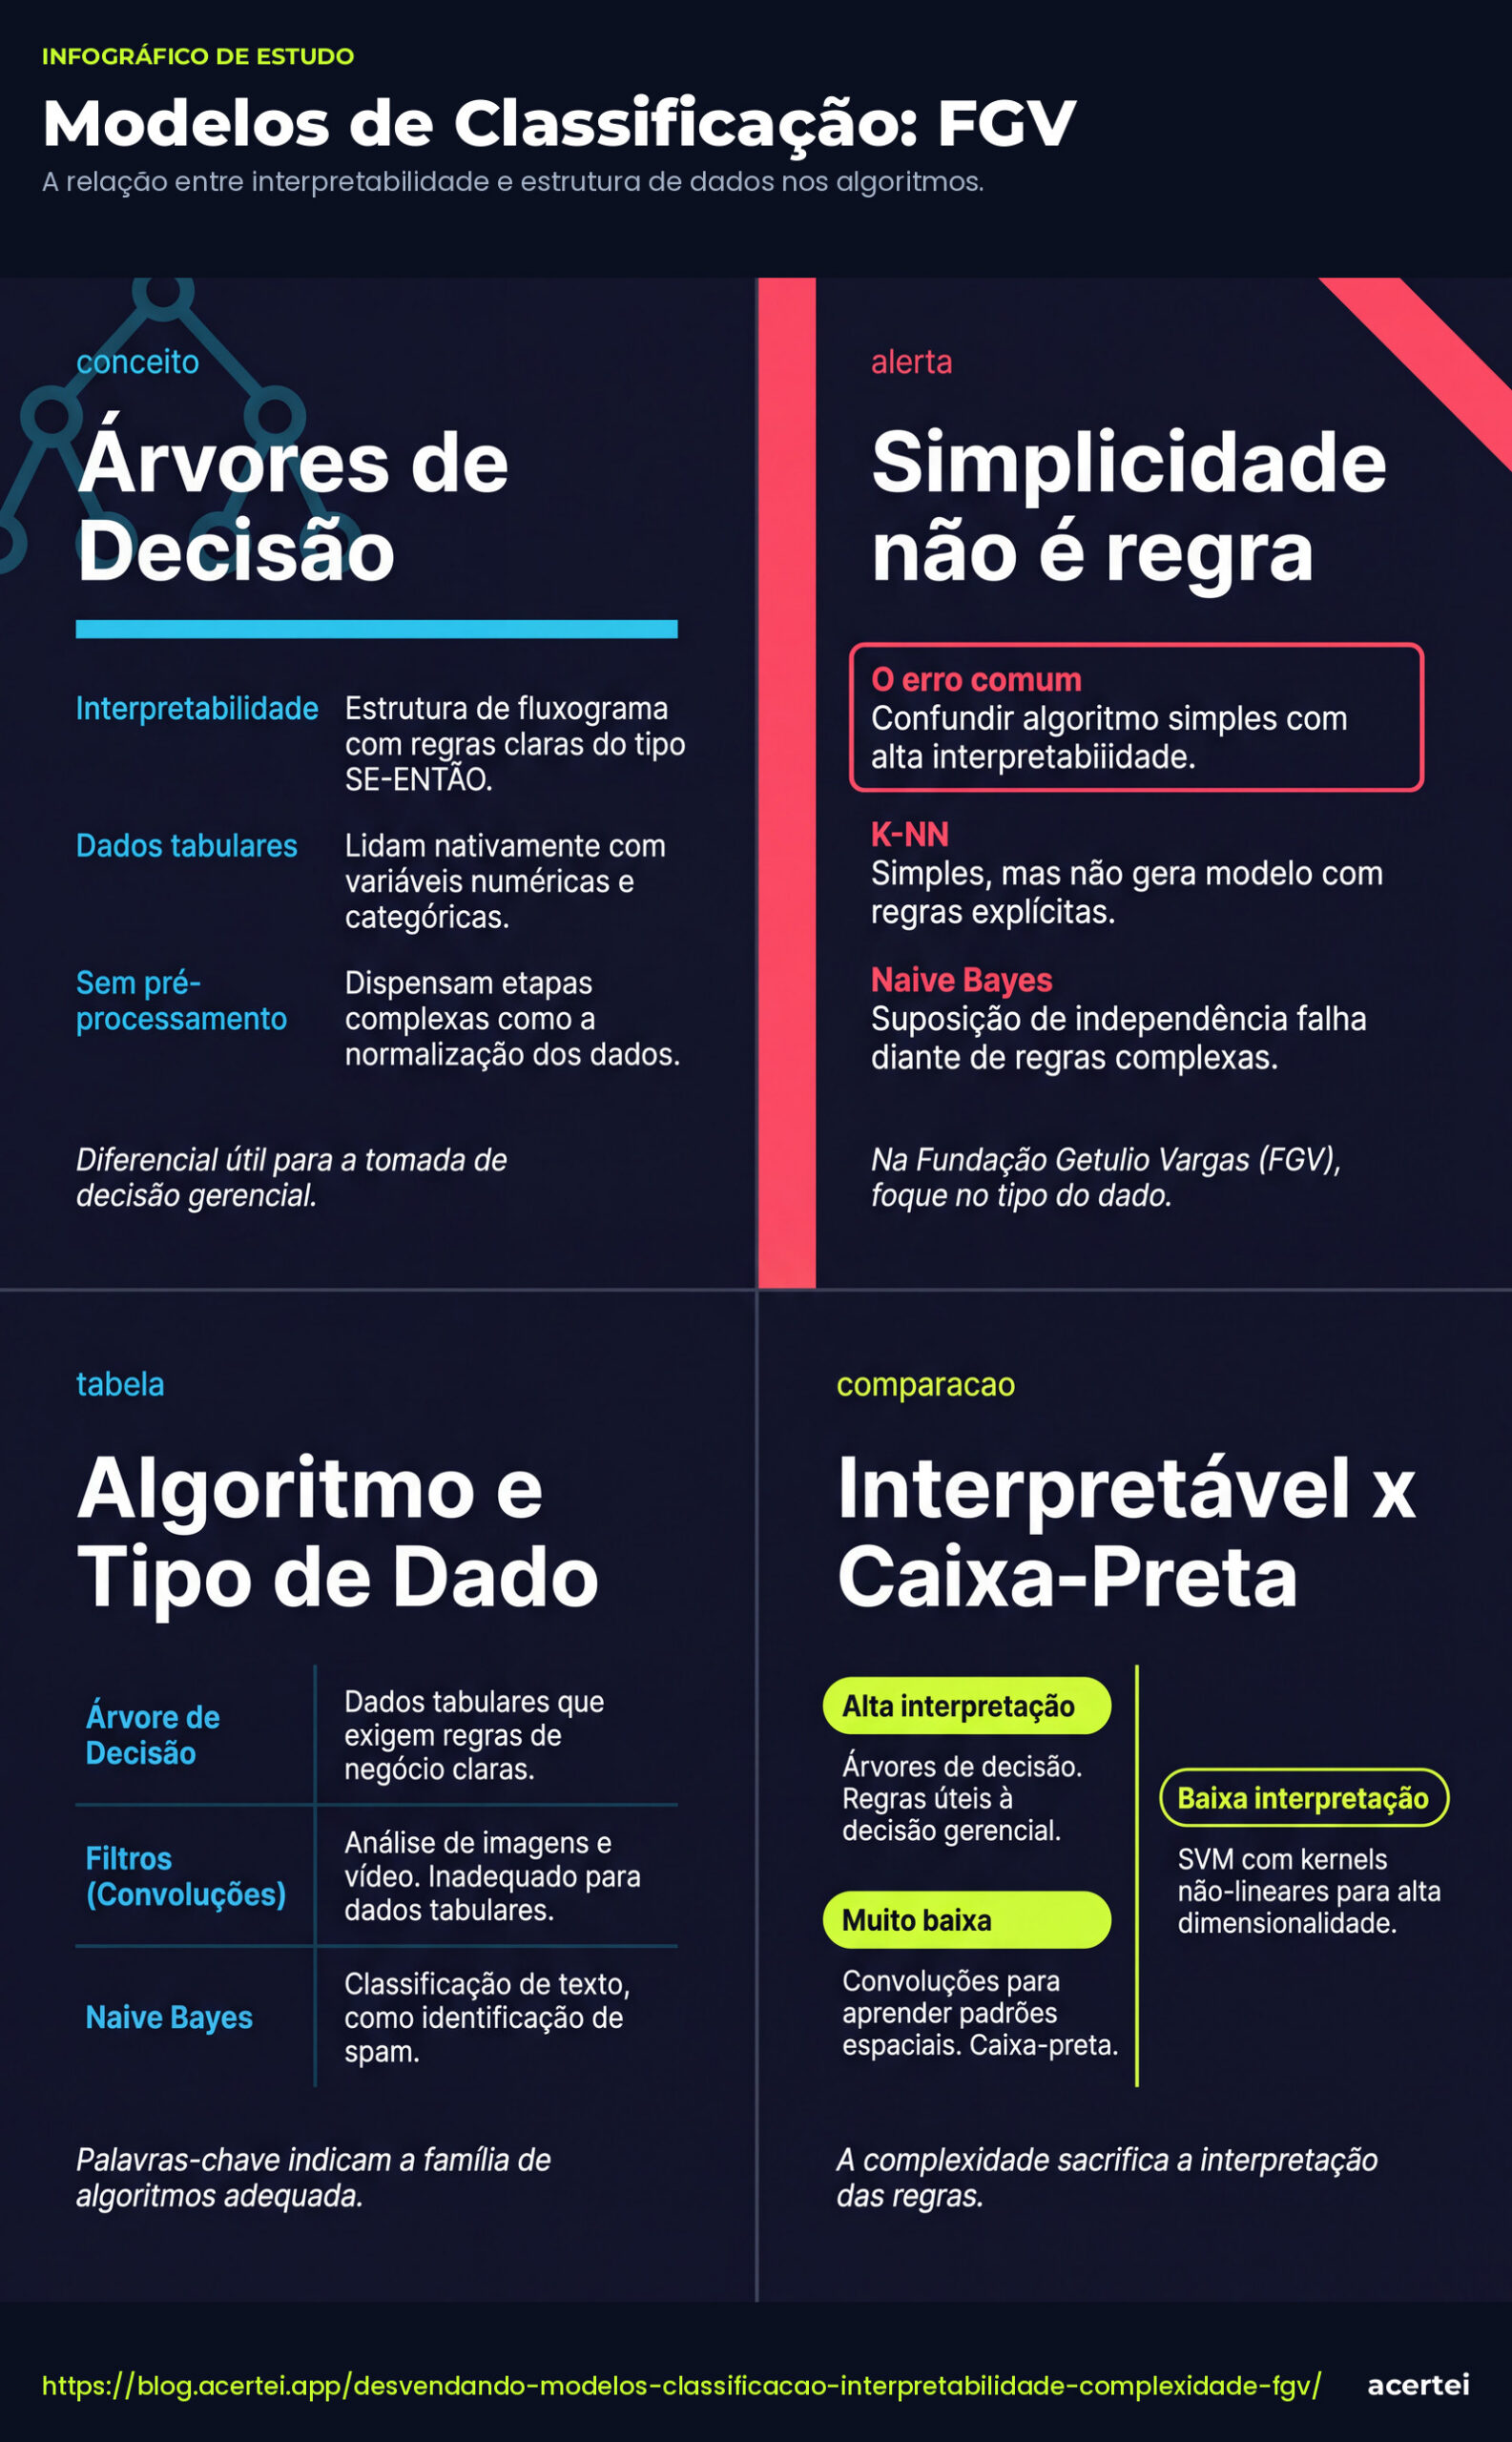
- Alta Interpretabilidade: A principal vantagem das árvores de decisão é sua transparência. O caminho percorrido da raiz até uma folha pode ser traduzido em uma regra lógica clara (ex: “SE o cliente tem menos de 6 meses de contrato E utiliza o serviço X, ENTÃO a probabilidade de cancelamento é de 85%”). Isso atende diretamente ao requisito de interpretabilidade.
- Ideal para Dados Tabulares: Elas lidam nativamente com dados tabulares, aceitando tanto variáveis numéricas quanto categóricas sem a necessidade de pré-processamento complexo como a normalização.
- Captura de Relações Complexas: As árvores de decisão são capazes de modelar relações não-lineares e interações complexas entre as variáveis, o que é ideal para o cenário de “regras de escolha complexas”.
Análise das Alternativas Incorretas: Por que as Outras Opções Falham?
Entender o erro das outras alternativas é tão importante quanto saber a certa.
- A) Naive Bayes: Este algoritmo é baseado no teorema de Bayes e assume uma premissa “ingênua” (naive) de que as variáveis são independentes entre si. Embora seja rápido e relativamente interpretável, sua forte suposição de independência raramente se sustenta em problemas do mundo real com “regras de escolha complexas”, onde as variáveis interagem.
- C) K-Vizinhos Mais Próximos (K-NN): O K-NN classifica um ponto de dados com base na classe da maioria de seus “vizinhos” mais próximos. É um algoritmo simples, mas não gera um “modelo” explícito com regras que possam ser interpretadas. A lógica de uma previsão específica não é facilmente traduzida para uma regra de negócio. Além disso, pode ser computacionalmente caro para grandes datasets.
- D) Rede Neural Convolucional (CNN): As CNNs são extremamente poderosas, mas seu domínio é o de dados com estrutura espacial, como imagens. Aplicá-las a dados tabulares não é direto e, mais importante, as CNNs são consideradas modelos “caixa-preta” (black box), ou seja, possuem baixíssima interpretabilidade, o que contradiz o requisito principal do problema.
- E) Máquina de Vetores de Suporte (SVM): SVMs são eficazes em encontrar uma fronteira de decisão ótima entre classes. Quando os dados não são linearmente separáveis, eles usam o “truque do kernel” para mapear os dados para uma dimensão superior. No entanto, o uso de kernels complexos (como o RBF) torna o modelo muito difícil de interpretar, funcionando como uma “caixa-preta”, semelhante às redes neurais.
Expandindo o Conhecimento: Modelos Ensemble
Embora uma única árvore de decisão seja muito interpretável, ela pode sofrer de alta variância (overfitting), ou seja, se ajustar demais aos dados de treino e ter um desempenho ruim em dados novos. Para resolver isso, foram criados os modelos ensemble baseados em árvores, que combinam várias árvores para obter uma previsão mais robusta.
- Random Forest (Floresta Aleatória): Constrói várias árvores de decisão independentes em subconjuntos aleatórios dos dados e das variáveis e, para classificação, usa o “voto” da maioria das árvores. Aumenta a precisão e reduz o overfitting, mas perde um pouco da interpretabilidade direta de uma única árvore.
- Gradient Boosting (e suas variantes como XGBoost, LightGBM, CatBoost): Constrói árvores de forma sequencial, onde cada nova árvore tenta corrigir os erros da anterior. São alguns dos modelos de melhor desempenho para dados tabulares hoje, mas são ainda mais complexos e menos interpretáveis que o Random Forest.
Apesar da existência desses modelos mais potentes, a questão do concurso foi clara ao priorizar a interpretabilidade, tornando a árvore de decisão única a resposta correta.
Em resumo, a habilidade de traduzir a lógica de um modelo em regras de negócio compreensíveis é um requisito fundamental em muitos cenários. As árvores de decisão oferecem um equilíbrio ideal entre a capacidade de modelar relações complexas e a transparência, tornando-as a ferramenta certa para o problema proposto e um tópico essencial para sua aprovação.
Mapa da Aprovação: Resumo Esquematizado
| Algoritmo | Princípio de Funcionamento | Nível de Interpretabilidade | Ideal para… | Ponto Fraco no Contexto da Questão |
|---|---|---|---|---|
| Árvore de Decisão | Estrutura de fluxograma com regras “SE-ENTÃO”. | Alta | Problemas tabulares que exigem regras de negócio claras. | N/A (É a resposta correta) |
| Naive Bayes | Probabilidade baseada no Teorema de Bayes com suposição de independência das variáveis. | Média | Classificação de texto (spam), problemas com variáveis realmente independentes. | A suposição de independência falha em “regras complexas”. |
| K-Vizinhos Mais Próximos (K-NN) | Classificação por “voto” dos K vizinhos mais próximos no espaço de características. | Baixa | Busca por similaridade, sistemas de recomendação simples. | Não gera um modelo com regras explícitas e interpretáveis. |
| Rede Neural Convolucional (CNN) | Hierarquia de filtros (convoluções) para aprender padrões espaciais. | Muito Baixa (Caixa-Preta) | Análise de imagens, vídeo e dados com estrutura de grade. | Inadequada para dados tabulares e não é interpretável. |
| Máquina de Vetores de Suporte (SVM) | Encontra um hiperplano que maximiza a margem entre as classes. | Baixa (com kernels não-lineares) | Problemas de classificação com alta dimensionalidade. | O uso de kernels para regras complexas a torna uma “caixa-preta”. |
Teste Seus Conhecimentos: Questões de Fixação
Referências:
- Convolutional Neural Networks on Tabular Datasets (Part 1)
- How does a decision tree help with model interpretability?
- Decision Tree – GeeksforGeeks